تکثیر صدا به شما امکان میدهد ویژگیهای صوتی گوینده را از یک نمونه صوتی کوتاه با استفاده از نقطه پایانی Gemini API Voices ( POST /v1beta/voices ) تکثیر کنید. هر دو Gemini 3.8 Flash TTS ( gemini-3.8-flash-tts ) و Gemini 3.8 Flash-Lite TTS ( gemini-3.8-flash-lite-tts ) از تکثیر صدا پشتیبانی میکنند.
سریعترین راه برای تکثیر، تأیید رضایت و شنیدن صدای تکثیر شده، استفاده از تجربه تعاملی تکثیر صدا در Google AI Studio است. میتوانید کلیپهای مرجع و رضایت را مستقیماً در مرورگر ضبط یا آپلود کنید، پیشنمایش صدا را ببینید و شناسه voice_... حاصل را مستقیماً در کد برنامه خود کپی کنید.
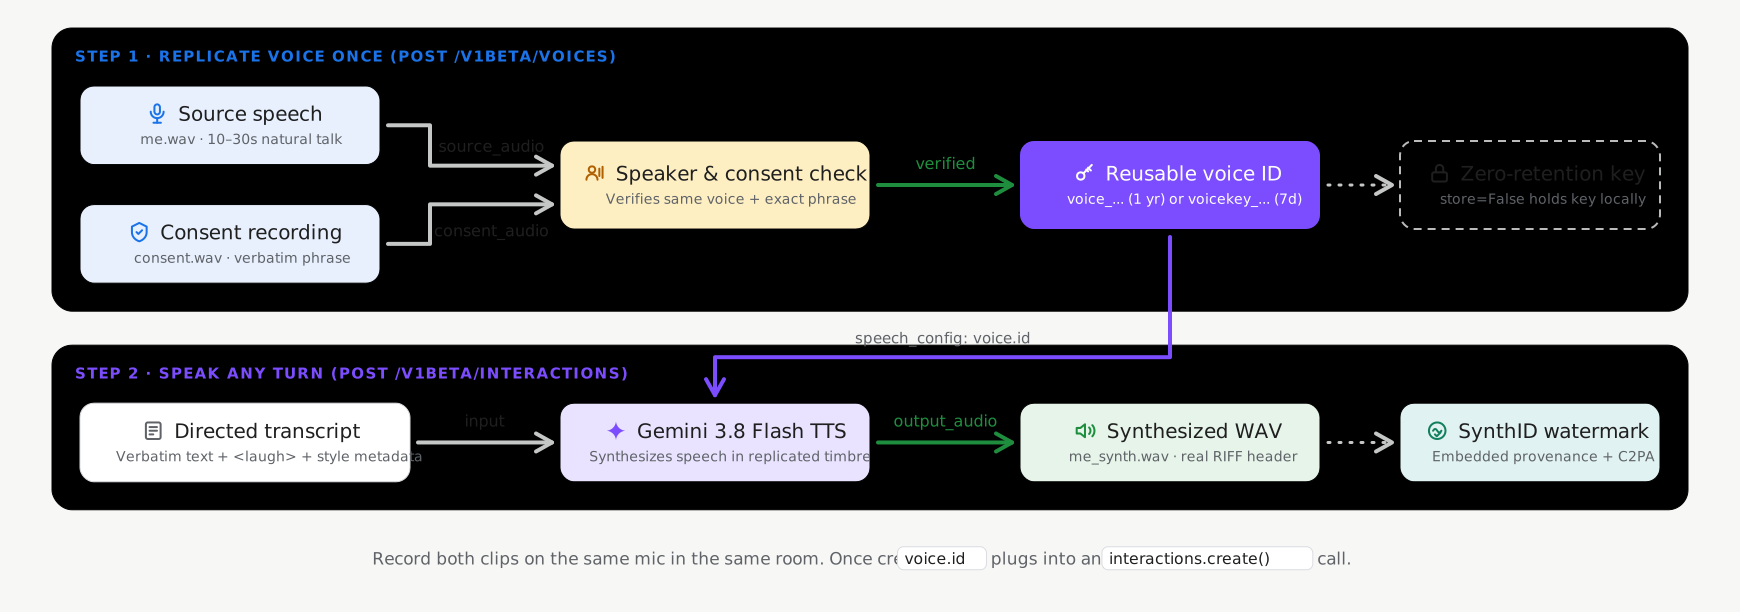
حالتهای ذخیرهسازی با وضعیت در مقابل حالت بدون وضعیت
تکرار صدا هنگام فراخوانی voices.create ( POST /v1beta/voices ) از دو حالت ذخیرهسازی پشتیبانی میکند و ذخیرهسازی با وضعیت به طور پیشفرض فعال است:
- ذخیرهسازی با وضعیت (
store=True، پیشفرض توصیهشده): گوگل نمایه صدای تأییدشده شما را در پروژهتان ذخیره میکند و یکvoice_idسبک و پایدار (replicated_voice.id، مانندvoice_abc123...) برمیگرداند. میتوانید اینvoice_idبه درخواستها ارسال کنید و آن را باvoices.list()،voices.get()وvoices.delete()مدیریت کنید. - کلیدهای مدیریتشده توسط کلاینت بدون وضعیت (
store=False، اختیاری): برای بارهای کاری که نیاز به عدم پایداری سمت سرور پروفایلهای صوتی بیومتریک دارند،store=Falseرا تنظیم کنید. API یکvoice_keyرمزگذاریشده و مستقل (replicated_voice.key، باvoicekey_...شروع میشود) را برمیگرداند که برنامه شما بهصورت محلی ذخیره میکند و مستقیماً در درخواستهای سنتز ارسال میکند.
| حالت ذخیره سازی | شناسه | محدودیت پروژه | میزان ماندگاری (TTL) |
|---|---|---|---|
صداهای حالتدار ( store=True ) | voice_... | ۲۰۰ صدا در هر پروژه (به اشتراک گذاشته شده در میان صداهای پیشنهادی و تکراری) | ۱ سال |
کلیدهای صوتی بدون وضعیت ( store=False ) | voicekey_... | مدیریتشده توسط مشتری | ۷ روز |
الزامات صوتی و رضایت
هر درخواست تکثیر CreateVoice به دو صدای ضبط شده واقعی انسان از یک بلندگوی بزرگسال نیاز دارد (24 کیلوهرتز مونو 16 بیتی WAV توصیه میشود):
- صدای مرجع (
source_audio): یک کلیپ ۱۰ تا ۳۰ ثانیهای از گفتار طبیعی و واضح از گویندهای که میخواهید صدایش را شبیهسازی کنید. - صدای رضایت (
consent_audio): صدای ضبطشدهی همان گوینده که به وضوح بیانیهی رضایت اجباری را به یکی از زبانهای پشتیبانیشده (مثلاً انگلیسی) میخواند: > «من صاحب این صدا هستم و به گوگل اجازه میدهم از این صدا برای ایجاد یک مدل صدای مصنوعی استفاده کند.»
ایجاد صدای تکثیر شده (پیشفرض با وضعیت)
برای ایجاد و ذخیره یک پروفایل صوتی تکثیر شده در پروژه خود، از Google GenAI SDK ( google-genai 2.25.0+ / @google/genai 2.24.0+) یا REST API با store=True استفاده کنید:
پایتون
import base64
from google import genai
client = genai.Client()
with open("reference_speaker.wav", "rb") as f:
source_b64 = base64.b64encode(f.read()).decode("utf-8")
with open("speaker_consent.wav", "rb") as f:
consent_b64 = base64.b64encode(f.read()).decode("utf-8")
# Create a persistent replicated voice (store=True)
replicated_voice = client.voices.create(
store=True,
voice={
"model": "gemini-3.8-flash-tts",
"type": "replicated",
"display_name": "Custom Replicated Speaker",
"replicated": {
"source_audio": {
"mime_type": "audio/wav",
"data": source_b64,
},
"consent_audio": {
"mime_type": "audio/wav",
"data": consent_b64,
},
},
},
)
print(f"Created voice ID: {replicated_voice.id}")
جاوا اسکریپت
import * as fs from "node:fs";
import { GoogleGenAI } from "@google/genai";
const ai = new GoogleGenAI();
const sourceB64 = fs.readFileSync("reference_speaker.wav").toString("base64");
const consentB64 = fs.readFileSync("speaker_consent.wav").toString("base64");
// Create a persistent replicated voice (store: true)
const replicatedVoice = await ai.voices.create({
store: true,
voice: {
model: "gemini-3.8-flash-tts",
type: "replicated",
display_name: "Custom Replicated Speaker",
replicated: {
source_audio: {
mime_type: "audio/wav",
data: sourceB64,
},
consent_audio: {
mime_type: "audio/wav",
data: consentB64,
},
},
},
});
console.log(`Created voice ID: ${replicatedVoice.id}`);
استراحت
SOURCE_B64=$(base64 -w 0 reference_speaker.wav)
CONSENT_B64=$(base64 -w 0 speaker_consent.wav)
curl "https://generativelanguage.googleapis.com/v1beta/voices" \
-H "x-goog-api-key: $GEMINI_API_KEY" \
-H "Content-Type: application/json" \
-X POST \
-d "{
\"store\": true,
\"voice\": {
\"model\": \"gemini-3.8-flash-tts\",
\"type\": \"replicated\",
\"display_name\": \"Custom Replicated Speaker\",
\"replicated\": {
\"source_audio\": {
\"mime_type\": \"audio/wav\",
\"data\": \"$SOURCE_B64\"
},
\"consent_audio\": {
\"mime_type\": \"audio/wav\",
\"data\": \"$CONSENT_B64\"
}
}
}
}"
با صدای تقلیدی خود، گفتار را ترکیب کنید
id برگردانده شده ( voice_... ) را هنگام فراخوانی generateContent در voiceConfig.voice وارد کنید:
پایتون
from google import genai
client = genai.Client()
response = client.models.generate_content(
model="gemini-3.8-flash-tts",
contents=[{
"role": "user",
"parts": [{
"text": (
"Hello! This audio was synthesized using a replicated"
" speaker voice."
),
"speech_metadata": {"style": "warm and conversational"},
}],
}],
config={
"response_modalities": ["AUDIO"],
"speech_config": {
"voice_config": {"voice": replicated_voice.id}
},
},
)
audio_bytes = response.candidates[0].content.parts[0].inline_data.data
with open("replicated_speech.wav", "wb") as f:
f.write(audio_bytes)
جاوا اسکریپت
import * as fs from "node:fs";
import { GoogleGenAI } from "@google/genai";
const ai = new GoogleGenAI();
const response = await ai.models.generateContent({
model: "gemini-3.8-flash-tts",
contents: [{
role: "user",
parts: [{
text: "Hello! This audio was synthesized using a replicated speaker voice.",
speechMetadata: { style: "warm and conversational" },
}],
}],
config: {
responseModalities: ["AUDIO"],
speechConfig: {
voiceConfig: { voice: replicatedVoice.id },
},
},
});
const data = response.candidates?.[0]?.content?.parts?.[0]?.inlineData?.data;
if (data) {
fs.writeFileSync("replicated_speech.wav", Buffer.from(data, "base64"));
}
استراحت
curl "https://generativelanguage.googleapis.com/v1beta/models/gemini-3.8-flash-tts:generateContent" \
-H "x-goog-api-key: $GEMINI_API_KEY" \
-H "Content-Type: application/json" \
-X POST \
-d '{
"contents": [{
"role": "user",
"parts": [{
"text": "Hello! This audio was synthesized using a replicated speaker voice.",
"speech_metadata": {
"style": "warm and conversational"
}
}]
}],
"generationConfig": {
"responseModalities": ["AUDIO"],
"speechConfig": {
"voiceConfig": {
"voice": "voice_YOUR_REPLICATED_VOICE_ID"
}
}
}
}'
مدیریت صداهای کپیشدهی ذخیرهشده
وقتی با store=True ایجاد شود، صداهای تکثیر شده شما میتوانند از طریق Voices API فهرست، فیلتر، بازرسی و حذف شوند (برای همه پارامترهای فیلتر به Extended Voice Library و فیلتر کردن مراجعه کنید):
پایتون
from google import genai
client = genai.Client()
# List stored replicated voices in your project
response = client.voices.list(type_=["replicated"])
for voice in response.voices or []:
print(voice.id, voice.display_name, voice.type)
# Retrieve a specific voice by ID
voice_details = client.voices.get(id=replicated_voice.id)
# Delete a stored replicated voice
client.voices.delete(id=replicated_voice.id)
جاوا اسکریپت
import { GoogleGenAI } from "@google/genai";
const ai = new GoogleGenAI();
// List stored replicated voices in your project
const response = await ai.voices.list({ type: ["replicated"] });
for (const voice of response.voices ?? []) {
console.log(voice.id, voice.display_name, voice.type);
}
// Retrieve a specific voice by ID
const voiceDetails = await ai.voices.get(replicatedVoice.id);
// Delete a stored replicated voice
await ai.voices.delete(replicatedVoice.id);
استراحت
# List stored replicated voices in your project
curl -G "https://generativelanguage.googleapis.com/v1beta/voices" \
-H "x-goog-api-key: $GEMINI_API_KEY" \
--data-urlencode "type=replicated"
# Retrieve a specific voice by ID
curl "https://generativelanguage.googleapis.com/v1beta/voices/voice_YOUR_REPLICATED_VOICE_ID" \
-H "x-goog-api-key: $GEMINI_API_KEY"
# Delete a stored replicated voice
curl -X DELETE "https://generativelanguage.googleapis.com/v1beta/voices/voice_YOUR_REPLICATED_VOICE_ID" \
-H "x-goog-api-key: $GEMINI_API_KEY"
گزینه: کلیدهای صوتی مدیریتشده توسط کلاینت بدون وضعیت ( store=False )
اگر برنامه شما نیازی به حفظ پروفایلهای صوتی در سمت سرور ندارد، هنگام ایجاد صدای تکثیر شده، store=False را تنظیم کنید. API یک voice_key رمزگذاری شده ( replicated_voice.key که با voicekey_... شروع میشود) را برمیگرداند که شما آن را در سمت کلاینت ذخیره میکنید و مستقیماً در voiceConfig.voice ارسال میکنید:
پایتون
import base64
from google import genai
client = genai.Client()
with open("reference_speaker.wav", "rb") as f:
source_b64 = base64.b64encode(f.read()).decode("utf-8")
with open("speaker_consent.wav", "rb") as f:
consent_b64 = base64.b64encode(f.read()).decode("utf-8")
# Create a stateless client-managed voice key (store=False)
replicated_voice = client.voices.create(
store=False,
voice={
"model": "gemini-3.8-flash-tts",
"type": "replicated",
"replicated": {
"source_audio": {"mime_type": "audio/wav", "data": source_b64},
"consent_audio": {"mime_type": "audio/wav", "data": consent_b64},
},
},
)
# Pass replicated_voice.key ("voicekey_...") directly in voice_config
response = client.models.generate_content(
model="gemini-3.8-flash-tts",
contents=[{
"role": "user",
"parts": [{
"text": "Hello! This audio uses a stateless client-managed voice key.",
"speech_metadata": {"style": "warm and conversational"},
}],
}],
config={
"response_modalities": ["AUDIO"],
"speech_config": {
"voice_config": {"voice": replicated_voice.key}
},
},
)
جاوا اسکریپت
import * as fs from "node:fs";
import { GoogleGenAI } from "@google/genai";
const ai = new GoogleGenAI();
const sourceB64 = fs.readFileSync("reference_speaker.wav").toString("base64");
const consentB64 = fs.readFileSync("speaker_consent.wav").toString("base64");
// Create a stateless client-managed voice key (store: false)
const replicatedVoice = await ai.voices.create({
store: false,
voice: {
model: "gemini-3.8-flash-tts",
type: "replicated",
replicated: {
source_audio: { mime_type: "audio/wav", data: sourceB64 },
consent_audio: { mime_type: "audio/wav", data: consentB64 },
},
},
});
// Pass replicatedVoice.key ("voicekey_...") directly in voiceConfig
const response = await ai.models.generateContent({
model: "gemini-3.8-flash-tts",
contents: [{
role: "user",
parts: [{
text: "Hello! This audio uses a stateless client-managed voice key.",
speechMetadata: { style: "warm and conversational" },
}],
}],
config: {
responseModalities: ["AUDIO"],
speechConfig: {
voiceConfig: { voice: replicatedVoice.key },
},
},
});
استراحت
SOURCE_B64=$(base64 -w 0 reference_speaker.wav)
CONSENT_B64=$(base64 -w 0 speaker_consent.wav)
curl "https://generativelanguage.googleapis.com/v1beta/voices" \
-H "x-goog-api-key: $GEMINI_API_KEY" \
-H "Content-Type: application/json" \
-X POST \
-d "{
\"store\": false,
\"voice\": {
\"model\": \"gemini-3.8-flash-tts\",
\"type\": \"replicated\",
\"replicated\": {
\"source_audio\": {\"mime_type\": \"audio/wav\", \"data\": \"$SOURCE_B64\"},
\"consent_audio\": {\"mime_type\": \"audio/wav\", \"data\": \"$CONSENT_B64\"}
}
}
}"
عبارات رضایت پشتیبانیشده بر اساس زبان
صدای رضایت باید دقیقاً همان جمله را به یکی از 30 زبان پشتیبانی شده به صورت واضح بخواند:
| زبان | زبان ( lang_id ) | بیانیه رضایتنامهی کلمه به کلمه |
|---|---|---|
| عربی | ar-XA | أنا مالك هذا الصوت وأوافق على أن تستخدم گوگل هذا الصوت لإنشاء نموذج صوتى اصطناعي. |
| بنگالی | bn-IN | আমি এই ভয়েসের মালিক এবং আমি একটিসিক ভয়েস মডেল তৈরি করতে এই ভয়েস ব্-যবহা Google সাথে সম্মতি দিচ্ছি। |
| چینی (سادهشده) | zh-CN | 我是此声音的拥有者并授权谷歌使用此声音创建语音合成模型 |
| هلندی | nl-NL | Ik ben de eigenaar van deze stem en ik geef Google toestemming om deze stem te gebruiken om een synthetisch stemmodel te maken. |
| انگلیسی (آمریکایی) | en-US | من مالک این صدا هستم و به گوگل اجازه میدهم از این صدا برای ایجاد یک مدل صدای مصنوعی استفاده کند. |
| انگلیسی (بریتانیا) | en-GB | من مالک این صدا هستم و به گوگل اجازه میدهم از این صدا برای ایجاد یک مدل صدای مصنوعی استفاده کند. |
| انگلیسی (هند) | en-IN | من مالک این صدا هستم و به گوگل اجازه میدهم از این صدا برای ایجاد یک مدل صدای مصنوعی استفاده کند. |
| انگلیسی (استرالیا) | en-AU | من مالک این صدا هستم و به گوگل اجازه میدهم از این صدا برای ایجاد یک مدل صدای مصنوعی استفاده کند. |
| فرانسوی (فرانسه) | fr-FR | یکی از ویژگیهای اختصاصی Cette Voix و j'autorise Google با استفاده از cette voix pour créer un modèle de voix synthétique. |
| فرانسوی (کانادا) | fr-CA | یکی از ویژگیهای اختصاصی Cette Voix و j'autorise Google با استفاده از cette voix pour créer un modèle de voix synthétique. |
| آلمانی | de-DE | Ich bin der Eigentümer dieser Stimme und bin damit einverstanden, dass Google diese Stimme zur Erstellung eines synthetischen Stimmmodells verwendet. |
| گجراتی | gu-IN | در این مورد મોડલ બનાવવા માટે આ વોઈસનો ઉપયોન કરીઇ હું સંમતિ આપું છું |
| هندی | hi-IN | आवाज मॉडल बनाने के लिए Google को इस आवाज कोा लिए करने की सहमति देता हूं |
| اندونزیایی | id-ID | Saya pemilik suara ini dan saya menyetujui Google menggunakan suara ini untuk membuat model soara sintetis. |
| ایتالیایی | it-IT | با استفاده از گوگل برای ایجاد یک مدل از صدای سینتتیک استفاده می شود. |
| ژاپنی | ja-JP | 私はこの音声の所有者であり、Googleがこの音声を使用して音声合成モデルを作成することを承認します。 |
| کانارا | kn-IN | ನಾನು ಈ ಧ್ವನಿಯ ಮಾಲಿಕ ಮತ್ತು ಸಂಶ್ಲೇಷಿಕ ಮಾದರಿಯನ್ನು ರಚಿಸಲು ಈ ಧ್ವನಿಯನ್ನು ಬಳಸಿಕೊಂಡುಗೂಗಲ್ ಗೆ ನಾನು ಸಮ್ಮತಿಸುತ್ತೇನೆ. |
| کره ای | ko-KR | 나는 이 음성의 소유자이며 구글이 이 음성을 사용하여 음성 구글이 이 음성을 사용하여 음성 ꕩ성채채 허용합니다. |
| مالایالامی | ml-IN | ഈ ശബ്ദത്തിന്റെ ഉടമ ഞാനാണ്، ഒരു സിന്മ വോയ്സ് മോഡൽ സൃഷ്ടിക്കാൻ ഈ ശബ്ദം ഉപയോഗിക്കുന്നതിന് ഞാൻ Google-ന് സമ്മതം ക്ുനതിന് ഞാൻ Google-ന് സമ്മതം ക്ുതം. |
| مراتی | mr-IN | मी या आवाजाचा मालक आहे आणि सिंथेट्कक मॉडेल तयार करण्यासाठी हा आवाज वापरण در گوگل संमती देतो |
| لهستانی | pl-PL | Jestem właścicielem tego głosu i wyrażam zgodę na wykorzystanie go przez Google w celu utworzenia syntetycznego modelu głosu. |
| پرتغالی (برزیل) | pt-BR | Eu sou o proprietário desta voz e autorizo o Google a usá-la para criar um modelo de voz sintética. |
| روسی | ru-RU | Я являюсь владельцем этого голоса و даю согласие Google به использование этого голоса для создания модели синтетического голоса. |
| اسپانیایی (اسپانیا) | es-ES | Soy el propietario de esta voz y doy mi consentimiento para que Google la utilice برای ایجاد مدلی از voz sintética. |
| اسپانیایی (آمریکایی) | es-US | Soy el propietario de esta voz y doy mi consentimiento para que Google la utilice برای ایجاد مدلی از voz sintética. |
| تامیل | ta-IN | நான் இந்த குரலின் உரிமையாளர் மற்றுு செயற்கை குரல் மாதிரியை உருவாக்கவா்க இல் பயன்படுத்த குகல்க்கு நான் ஒப்புக்கொள்கிறேன். |
| تلوگو | te-IN | నేను ఈ వాయిస్ యజమానిని మరియు సింతటి google. |
| تایلندی | th-TH | در گوگل ใช้เสียงนี้เพื่อสร้างแ บบจำลองเสียงสังเคราะห์ |
| ترکی | tr-TR | Bu sesin sahibi benim ve Google'ın bu sesi kullanarak sentetik bir ses modeli oluşturmasına izin veriyorum. |
| ویتنامی | vi-VN | Tôi là chủ sở hữu giọng nói này và tôi đồng ý cho Google sử dụng giọng nói này để tạo mô hìhnh gi. |
بهترین روشها برای ضبط صدای مرجع
- ضبط در یک محیط آرام: اکوی اتاق، نویز پسزمینه، موسیقی و صداهای همپوشانی را به حداقل برسانید.
- شرایط ضبط را مطابقت دهید: هم
source_audioو همconsent_audioرا روی یک میکروفون و در یک محیط آکوستیک ضبط کنید تا بررسی تأیید گوینده با موفقیت انجام شود. - تبدیل به فرمت WAV مونو با فرکانس ۲۴ کیلوهرتز: برای بهترین نتیجه، قبل از کدگذاری، صدای ورودی را به فرمت WAV PCM با فرکانس ۲۴ کیلوهرتز مونو و ۱۶ بیت نمونهبرداری مجدد کنید.
قدم بعدی چیست؟
- بیاموزید که چگونه در طراحی صدا، شخصیتهای سفارشی را از توضیحات متنی ایجاد کنید.
- سبکبندی نوبتی، تگهای درونخطی و گفتگوی چندگوینده را در راهنمای تبدیل متن به گفتار بررسی کنید.